Die Statusseite war grün
Mittwochvormittag, kurz nach zehn. Unsere Service Provider Console kommt nicht mehr an ihre Datenbank. Die VSPC läuft als Cloud-Server bei Hetzner, der SQL-Server auf einer dedizierten Maschine daneben. Verbunden sind beide über ein privates Netz: Cloud-Netzwerk auf der einen Seite, vSwitch auf der anderen, gekoppelt über ein Gateway, das Hetzner bereitstellt.
Ping in beide Richtungen: Timeout.
Erst die eigene Konfiguration
Die naheliegende Vermutung ist immer die eigene Seite. Also durchgesehen: Routing auf beiden Servern, VLAN-Tag am NIC-Team, die Kopplung von vSwitch und Cloud-Netzwerk im Robot und in der Cloud Console. Alles so, wie es in der Hetzner-Anleitung steht. Auf der VSPC fand sich eine alte, falsche Route, die aber nicht aktiv war. Kein Routing-Problem.
Die Statusseite von Hetzner zeigte zu diesem Zeitpunkt keine Störung an vSwitch oder Cloud-Netzwerken. Eine Wartung in einem anderen Rechenzentrum, eine Ankündigung zu neuen vSwitch-Grenzen, sonst nichts.
Also weiter unten suchen.
Der Beweis lag im ARP-Cache
Auf dem dedizierten Server den ARP-Cache geleert und das vSwitch-Gateway angesprochen:
arp -d *
ping 10.0.0.17
arp -a
Die Antwort kam vom eigenen Interface: Ziel nicht erreichbar. Und im ARP-Cache stand für das Gateway kein Eintrag. Der Server fragte korrekt getaggt im VLAN nach der MAC-Adresse des Gateways, und niemand antwortete.
Das ist der entscheidende Unterschied. Ein fehlender Ping kann vieles heißen. Ein fehlender ARP-Eintrag heißt: Auf Layer 2 kommt nichts zurück. Routing, Firewall und alles darüber sind dann egal.
Eine Falle gab es dabei: Das vSwitch-Gateway beantwortet grundsätzlich keinen Ping, auch wenn alles funktioniert. Wer nur pingt, hält ein gesundes Gateway für tot. Der Test läuft deshalb immer über ARP oder über eine echte TCP-Verbindung zum Zielserver.
Unterwegs haben wir die MTU des vSwitch-Interfaces auf 1400 gesetzt, wie Hetzner es für vSwitches vorschreibt . Das hat an der Störung nichts geändert, ARP-Pakete sind winzig. Gefehlt hatte es trotzdem.
Die Störung, die es offiziell noch nicht gab
Ticket bei Hetzner, mit den Testergebnissen. Später stand die Störung auch auf der Statusseite, rückwirkend: Probleme mit vSwitches, Paketverlust und abgebrochene Verbindungen, seit zehn Uhr unserer Zeit. Am frühen Nachmittag meldete Hetzner, es sollte wieder gehen, man möge auf den dedizierten Servern den ARP-Cache leeren.
ARP-Cache geleert, das NIC-Team neu gestartet, und das Gateway antwortete wieder. Die Verbindung zur Datenbank stand.
Eine grüne Statusseite ist eine Momentaufnahme. Wenn die eigene Messung etwas anderes sagt, gewinnt die Messung.
Der Workaround, der etwas anderes aufdeckte
Bis Hetzner den Fehler behoben hatte, musste die VSPC trotzdem laufen. Der Workaround: Die VSPC spricht den SQL-Server vorübergehend über seine öffentliche Adresse an, Port 1433 per Firewall streng auf die eine Quelladresse beschränkt.
Bevor wir das freigaben, haben wir nachgesehen, ob die Verbindung verschlüsselt ist:
SELECT s.login_name, c.client_net_address, c.encrypt_option
FROM sys.dm_exec_connections c
JOIN sys.dm_exec_sessions s ON c.session_id = s.session_id;
encrypt_option stand auf FALSE. Die Anmeldung läuft bei SQL Server immer verschlüsselt, die Nutzdaten danach nicht. Und das galt nicht erst für den Umweg über das Internet. Im privaten Netz war es genauso gewesen, die ganze Zeit. Es war nur nie aufgefallen, weil niemand gefragt hatte.
Veeam dokumentiert für die VSPC keine Einstellung dazu. Unsere Nachfrage beim Support ergab: In einer älteren Version funktionierte erzwungene Verschlüsselung auf SQL-Seite nicht, ab Version 9.0 ist das behoben, und im Labor von Veeam lief es fehlerfrei. Eine offizielle Freigabe gibt es nicht, die Empfehlung lautet: einschalten und beobachten.
Nicht dokumentiert heißt nicht verboten
Das ist die unbequeme Lage, die man bei Herstellern öfter hat. Nicht dokumentiert heißt nicht unterstützt. Es heißt aber auch nicht, dass es nicht geht. Wer an dieser Stelle einfach wartet, bis der Hersteller es aufschreibt, lässt die Verbindung zur Datenbank so lange offen.
Wir haben die Verschlüsselung deshalb eingeschaltet, aber nicht blind. Erst den Workaround zurückgebaut, dann im Wartungsfenster eine Woche nach der Störung:
- Version prüfen. Die VSPC muss mindestens auf 9.0 sein, sonst ist das bekannte Problem noch drin.
- Den Rückweg vorher bereitlegen. Läuft etwas schief, wird die Einstellung wieder auf Nein gesetzt und der Dienst neu gestartet. Das steht im Ticket, bevor man anfängt, nicht danach.
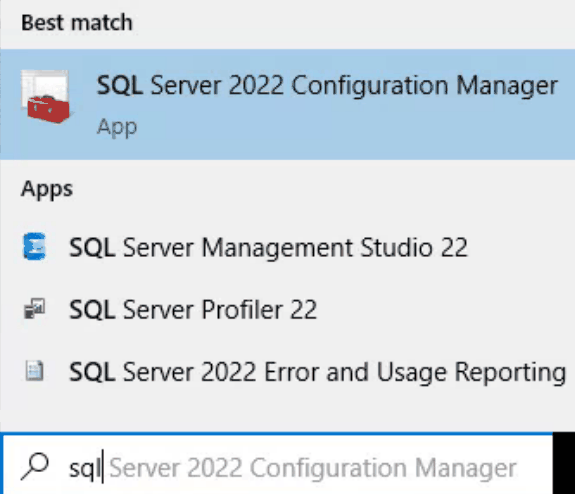
- Auf SQL-Seite erzwingen. Das geht im SQL Server Configuration Manager, nicht im Management Studio. Auf dem SQL-Server im Startmenü nach „sql“ suchen:
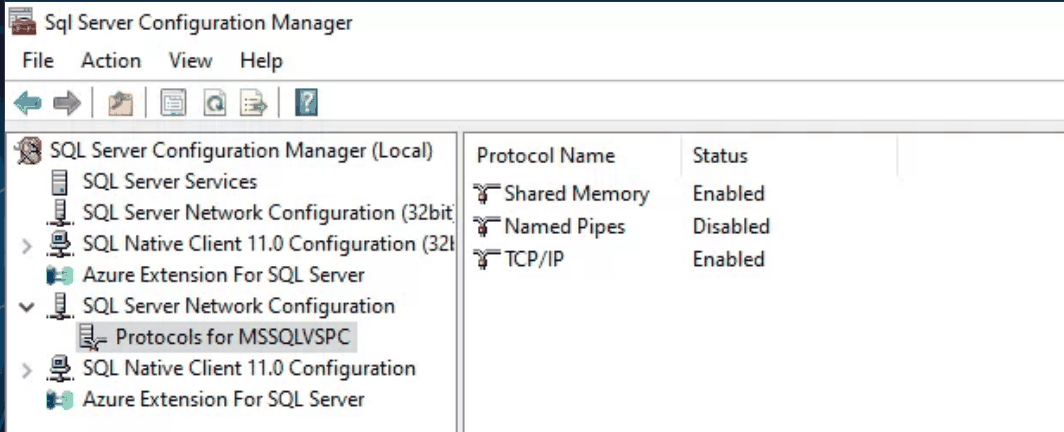
Unter SQL Server Network Configuration stehen die Protokolle der Instanz:
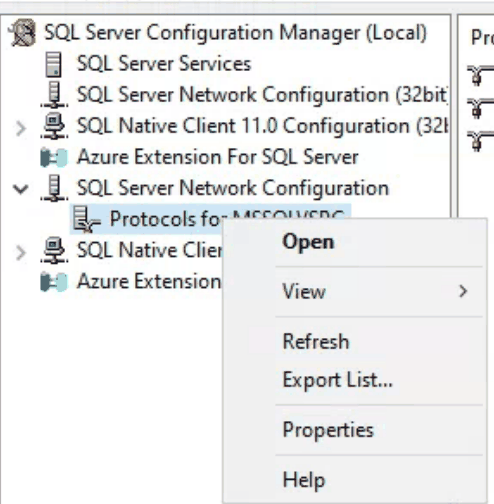
Rechtsklick auf Protocols for und die Instanz, dann Properties:
Im Reiter Flags steht Force Encryption. Auf Yes setzen, mit OK bestätigen:
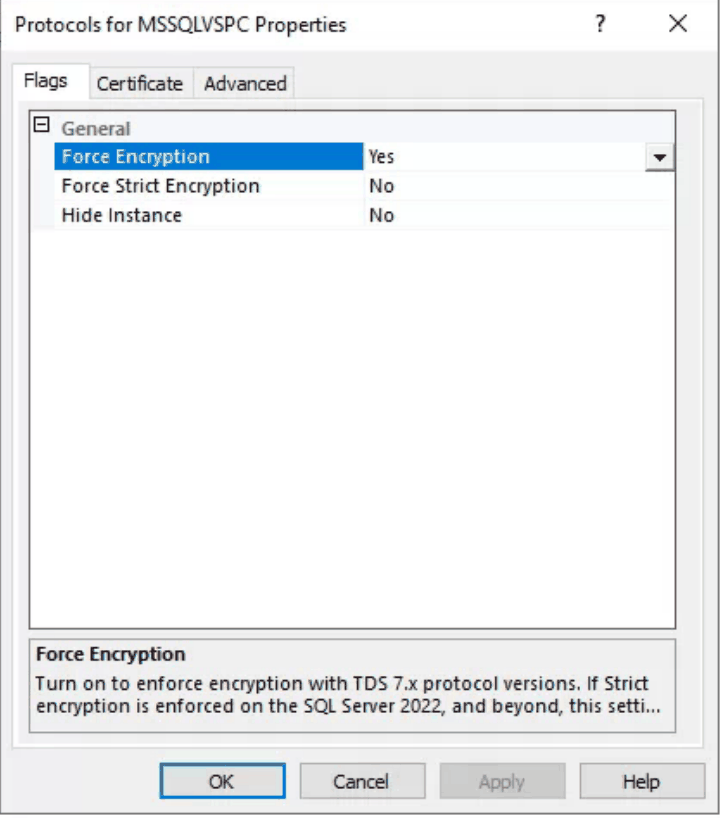
Die Einstellung greift erst nach einem Neustart des SQL-Dienstes, die VSPC ist dabei kurz ohne Datenbank. Ohne eigenes Zertifikat nimmt SQL Server ein selbst erzeugtes. Besser ist eines, das auf den Namen des Servers ausgestellt ist.
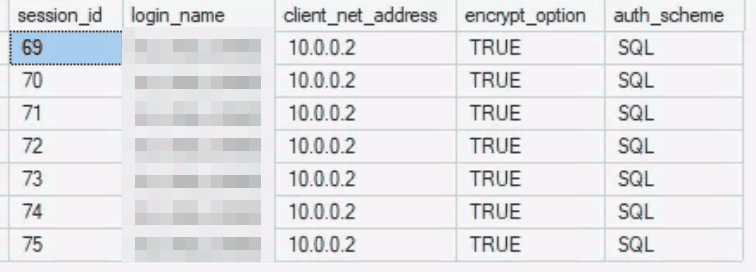
- Nachsehen, ob es wirkt. Dieselbe Abfrage wie oben, eingeschränkt auf das Dienstkonto der VSPC. Jede Sitzung kommt jetzt aus dem privaten Netz und zeigt
TRUE:
- Beobachten. Ein bis zwei Tage lang Anmeldung, Mandanten, Jobs, Abrechnung und die Logs der VSPC im Blick behalten.
Was wir daraus mitnehmen
- Bei Verbindungsabbrüchen zuerst Layer 2. ARP-Cache leeren, Gateway ansprechen, ARP-Tabelle ansehen. Fehlt der Eintrag, ist die eigene Routing-Tabelle nicht das Problem.
- Nicht jedes Gateway antwortet auf Ping. Testen über ARP oder über die echte Verbindung, etwa
Test-NetConnection <Ziel> -Port 1433. - Die Statusseite ist kein Beweis. Die eigene Messung ist einer. Mit ihr im Ticket geht es schneller.
- Ein Workaround ist ein guter Moment, die Annahmen zu prüfen. Wir hätten ohne den Umweg über die öffentliche Adresse nicht nachgesehen und nicht gemerkt, dass SQL nie verschlüsselt gesprochen hatte.
- Verschlüsselung erzwingen, auch im privaten Netz. Ein privates Netz ist ein Netz, das man nicht kontrolliert, wenn es beim Provider läuft.
- Den Workaround zurückbauen, sobald der Fehler behoben ist: Firewall-Regeln, Listener auf der öffentlichen Adresse, Umleitung auf der VSPC. Mit Checkliste, damit nichts stehen bleibt.