Den Decryptor an die Leine legen
TL;DR
- Der Decryptor der Täter nimmt keinen Pfad und bearbeitet jede Datei mit der Endung, die er erreicht, auch Originale auf Netzlaufwerken.
- Also einsperren: nur Kopien, Originale gehasht und gesperrt, Windows Sandbox oder eine eigene VM ohne Netzwerkkarte, die danach nie wieder startet.
- Den geretteten Server nur lesend auslesen: Platte an eine eigene Linux-VM,
blockdev --setroundmount -o ro,noload. Plus drei Fehler, die uns eine Nacht gekostet haben.
Im Fall, den wir in Der Decryptor läuft, und die großen VMs bleiben zu erzählen, lag ein Decryptor der Täter vor. Ein Programm von Kriminellen, das man auf die letzten Kopien seiner Daten loslässt. Das will vorbereitet sein.
Welche Dateien überhaupt durch den Decryptor gehören, steht in Verschlüsselt oder nur umbenannt? Nur umbenannte Dateien gehören ausdrücklich nicht dazu.
Er nimmt keinen Pfad
Man kann dem Decryptor nicht sagen, welche Datei er bearbeiten soll. Er sucht selbst, und zwar alles mit der Endung der Ransomware, das er erreicht. Lokale Platten, verbundene Netzlaufwerke, eingehängte Freigaben. Auch die Originale, von denen man gerade eine Kopie gezogen hat.
Und er schreibt in die Datei selbst. Geht etwas schief, ist sie verändert, und das Original auch, wenn es erreichbar war.
So haben wir ihn eingesperrt
- Originale hashen, bevor irgendetwas läuft. Dann lässt sich später beweisen, ob sich etwas verändert hat.
- Nur auf Kopien arbeiten, in einem eigenen Arbeitsordner.
- Snapshot der Analyse-VM vor jedem Lauf.
- Alle Netzlaufwerke trennen.
- Jeden anderen Ordner mit betroffenen Dateien sperren. Schreiben und Löschen für „Jeder“ verbieten, danach die Sperre wieder entfernen:
icacls D:\originale /deny "*S-1-1-0:(OI)(CI)(W,D,DC)"
icacls D:\originale /remove:d "*S-1-1-0"- Wo das nicht geht, nur lesend zugreifen. Auf einem Cloud-Speicher mit SMB greift
icaclsnicht. Dort haben wir ein Unterkonto angelegt, das nur lesen darf.
Besser als alle Sperren ist eine Umgebung, in der der Decryptor nichts anderes sieht. Die Windows Sandbox hängt nur den Arbeitsordner ein und hat auf Wunsch kein Netz:
<Configuration>
  <Networking>Disable</Networking>
  <MappedFolders>
    <MappedFolder>
      <HostFolder>D:\arbeit</HostFolder>
      <SandboxFolder>C:\arbeit</SandboxFolder>
      <ReadOnly>false</ReadOnly>
    </MappedFolder>
  </MappedFolders>
</Configuration>
Zwei Regeln noch. Nie zweimal auf dieselbe Datei. Ist ein Lauf fehlgeschlagen, kommt eine frische Kopie vom Original. Und der Virenscanner schlägt an. Defender meldet beim Decryptor „Ransomware found“. Das ist erwartbar, ein Programm, das massenhaft Dateien umschreibt, sieht genau so aus. Die Maschine kommt danach trotzdem vom Netz.
Eine schmutzige Maschine, eine saubere
Wir sind noch einen Schritt weiter gegangen. Der Decryptor lief auf einer eigenen VM, und nur dort. Ihre Netzwerkkarte haben wir entfernt und danach nie wieder angeschlossen. Auf dieser VM haben wir alles vorbereitet, entschlüsselt und geprüft. Danach haben wir sie heruntergefahren, die Datenplatte abgehängt und an eine zweite, saubere VM gehängt. Weitergearbeitet wurde nur noch dort.
Der Grund: Wir wissen nicht, was ein Programm der Täter außer Entschlüsseln noch tut. Auf der zweiten Maschine läuft nichts davon, und nichts kann versehentlich aufgerufen werden. Die erste VM wird nicht mehr gestartet.
Drei Fehler in einer Nacht
Nicht alles lief glatt. Drei Fehler haben uns Stunden gekostet.
Eine Platte mit Snapshot an eine andere VM gehängt. Ausgerechnet beim Umhängen auf die saubere Maschine. Die Datenplatte hatte noch einen Snapshot, den wir vor dem Decryptor angelegt hatten, genau wie oben empfohlen. Nach dem Umhängen war die Decryptor-VM zerstört und die Datenplatte auf dem Stand vor dem Decryptor. Die Arbeit des Abends war weg. Seitdem gilt: erst den Snapshot zusammenführen, dann umhängen. Oder die Ergebnisse kopieren statt die Platte zu bewegen.
Veeam braucht auch isoliert eine IP. Die Analyse-VM hatte keine Netzwerkadresse, aus gutem Grund. Der Import der geretteten Sicherung scheiterte daran:
Failed to resolve connection point to IP addressesLösung: Netzwerkkarte in eine Portgruppe ohne Uplink, feste IP. Isoliert bleibt die Maschine trotzdem.
Dasselbe beim geretteten Server selbst. Er startete im isolierten Netz, fand kein DHCP und lief ohne Adresse. Für die Sicherheit genau richtig. Die Daten haben wir deshalb gar nicht über das Netz geholt, sondern anders, siehe unten.
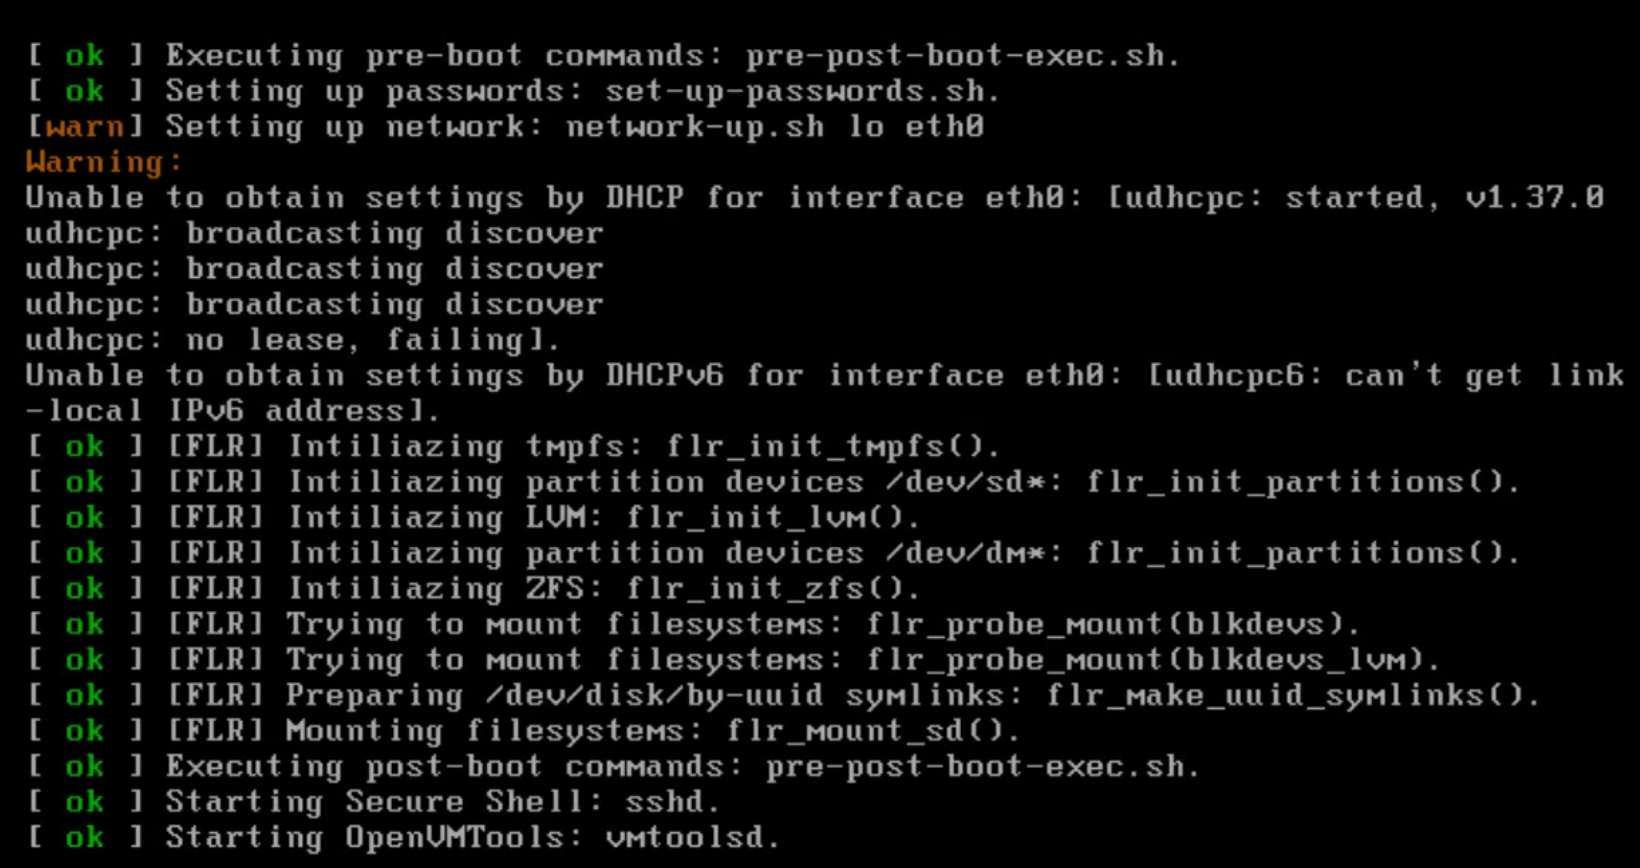
Veeam offline installieren. Das Setup scheiterte auf der isolierten Maschine an der Signaturprüfung einer Bibliothek. Seitdem gilt: installieren, solange die Maschine noch Netz hat, erst dann isolieren.
Die Daten nur lesend herausholen
Auch den geretteten Server haben wir nicht weiter laufen lassen. Er war ein Linux-Server aus einer verschlüsselten Umgebung, wir wussten nicht, was darauf noch wartet. Gestartet war er per Instant Recovery: Die Platte liegt dabei auf dem NFS-Datastore von Veeam, Schreibzugriffe landen nur in einem Redo-Log, die Sicherung selbst bleibt unberührt.
Wir haben ihn wieder heruntergefahren und seine Platte in vSphere als vorhandene Festplatte an einen Linux-Server gehängt, den wir selbst verwalten. Ohne Snapshot, nach dem Unfall vom Vorabend.
Dort wurde sie nur lesend eingehängt:
blockdev --setro /dev/sdb /dev/sdb1 /dev/sdb2
blkid /dev/sdb2
mount -o ro,noload /dev/sdb2 /mnt/gerettet
blockdev --setro sperrt Gerät und Partitionen im Kernel gegen Schreiben. ro beim Einhängen allein reicht nicht: ext4 und XFS spielen beim Einhängen ein offenes Journal nach und schreiben dabei auf die Platte. Bei einer VM, die abrupt gestoppt wurde, ist das Journal fast immer offen. noload verhindert das bei ext4, bei XFS heißt die Option norecovery.
Damit waren es drei Schichten: Kernel-Schreibschutz, Einhängen ohne Journal, Redo-Log der Instant Recovery. Was wir nicht gemacht haben, aber empfehlen: blockdev --getro /dev/sdb2 muss 1 liefern. Und wer beweisen muss, dass nichts verändert wurde, zieht vorher und nachher sha256sum über das Gerät.
Ein paar Regeln aus derselben Nacht:
- Platte nur mit „Remove from virtual machine“ lösen, nie mit „Delete files from datastore“.
- Vor dem Umhängen aushängen (
umount). - Keine Snapshots an beteiligten VMs.
- Der Datastore der Instant Recovery ist langsam. Für längeres Arbeiten die VM per „Migrate to production“ auf einen echten Datastore verschieben.
Von dort ging es ohne Umweg über den geretteten Server weiter: per rsync über einen Jumphost auf ein eigenes Ziel kopiert, Prüfsummen über alle Dateien, Virenscan, Bereitstellung per SFTP nur lesend. Wie uns beim Virenscan ein eigener Fehler unterlief, steht in Null Funde heißt nicht sauber
. Der gerettete Server selbst hat nie wieder Netz gesehen.
Was bleibt
Ein Decryptor ist ein Werkzeug der Täter, kein Werkzeug der Wiederherstellung. Man setzt ihn ein wie eine Probe im Labor: auf Kopien, eingesperrt, mit Protokoll. Und auch dann ersetzt er nichts, siehe Ein Decryptor ist kein Backup .
Quellen
- Microsoft, Windows Sandbox: Konfigurationsdateien
- Microsoft, icacls